IA multimodale : au-delà du texte, ce que voient et entendent désormais vos outils
Image, audio, vidéo : un tour d'horizon concret des usages métier rendus possibles par les modèles multimodaux, et de ce qui reste encore fragile en production.
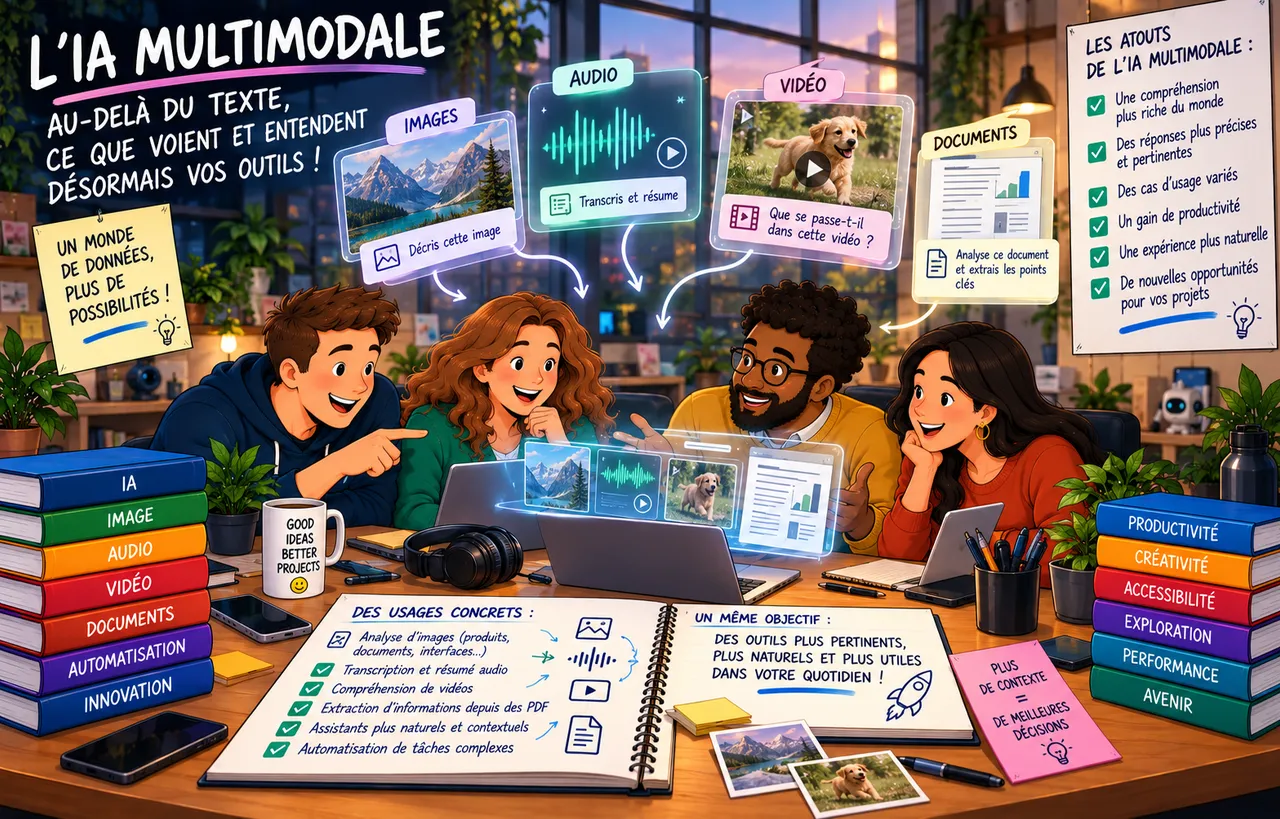
Il y a encore peu de temps, “utiliser l’IA” voulait dire taper une question dans une fenêtre de chat et lire une réponse. Aujourd’hui, le même modèle peut regarder la photo d’un tableau électrique, écouter l’enregistrement d’un rendez-vous client, parcourir un PDF scanné de quarante pages avec ses tableaux et ses schémas, ou commenter quelques minutes de vidéo. Ce sont les modèles dits “multimodaux” : ils traitent plusieurs types de contenus (texte, image, son, vidéo) dans un même raisonnement, au lieu d’empiler un outil par format.
Chez Agilap, nous voyons cette évolution arriver dans les projets de nos clients de deux façons. Du côté des équipes métier, la question devient très concrète : “est-ce que je peux enfin automatiser le traitement de ces factures photographiées, de ces comptes rendus oraux, de ces pièces jointes qui n’ont jamais voulu entrer dans un tableur ?” Du côté des développeurs, c’est une nouvelle brique à intégrer, avec ses coûts, ses limites et ses surprises.
La réponse honnête est : oui, dans pas mal de cas, et c’est même plus accessible qu’il y a un an. Mais certains usages restent fragiles, et un prototype bluffant en démonstration peut devenir décevant en production. Voici un tour d’horizon de ce qui fonctionne vraiment, de ce qui reste risqué, et de la manière dont nous recommandons d’aborder le sujet 🤔.
Ce que change vraiment la multimodalité
Avant les modèles multimodaux, traiter un document scanné demandait une chaîne d’outils : un logiciel de reconnaissance de caractères (OCR) pour extraire le texte, des règles ou des expressions régulières pour retrouver les champs utiles, puis souvent une correction manuelle. Chaque étape ajoutait ses propres erreurs, et le moindre changement de mise en page cassait l’ensemble.
Un modèle multimodal fait les choses autrement : il “regarde” directement le document comme le ferait un humain, avec sa mise en page, ses tableaux, ses tampons et ses annotations manuscrites, et il comprend le contexte. Une facture dont le total se trouve en bas à droite sur un modèle et en haut sur un autre ne nécessite plus deux configurations distinctes. Même logique pour l’audio : au lieu de transcrire d’abord puis d’analyser, le modèle peut tenir compte du ton, des hésitations ou de l’interlocuteur qui parle.
Mais concrètement, qu’est-ce que ça change pour une PME ? Surtout une chose : des données qui restaient inexploitées parce qu’elles n’avaient pas de format “propre” deviennent exploitables. Photos de chantier, messages vocaux, captures d’écran envoyées par les clients, enregistrements d’appels : tout ce qui dormait dans des dossiers ou des boîtes mail peut maintenant être lu, classé et résumé à un coût raisonnable.
Des usages métier qui fonctionnent déjà
Nous avons accompagné plusieurs PME sur des cas où la multimodalité apporte un gain mesurable, et pas seulement un effet de démonstration. Voici ceux qui nous paraissent les plus solides aujourd’hui.
La lecture de documents hétérogènes est probablement le cas le plus mature. Factures fournisseurs, bons de livraison, relevés, formulaires remplis à la main : un modèle multimodal extrait les informations utiles, les structure, et les envoie vers l’outil de gestion. Le gain vient surtout de la tolérance aux formats variés, là où l’OCR classique exigeait un paramétrage par fournisseur. Pour une entreprise qui reçoit des dizaines de formats différents, la différence est considérable.
La transcription et la synthèse de réunions ou d’appels est le deuxième cas d’usage à la maturité très correcte. Compte rendu automatique d’un rendez-vous client, extraction des décisions et des actions à mener, mise à jour du CRM : c’est un travail que personne ne fait vraiment bien manuellement, et où une erreur mineure de transcription n’a généralement pas de conséquence grave, puisqu’un humain relit le résumé avant de le diffuser.
L’analyse d’images terrain gagne du terrain dans les métiers techniques. Un technicien photographie une installation, un équipement ou un dommage, et l’outil aide à identifier la référence, signaler une anomalie visible ou pré-remplir un rapport d’intervention. Il ne remplace pas l’expertise du technicien : il lui évite de ressaisir ce qu’il vient déjà de constater.
Le support client avec pièces jointes visuelles est un cas moins spectaculaire mais très rentable. Quand un client envoie une capture d’écran d’une erreur ou la photo d’un produit défectueux, le modèle peut comprendre ce qui est montré, proposer une première réponse et router la demande vers la bonne personne, sans demander au client de tout décrire par écrit.
Ce qui reste fragile en production
C’est ici que nous devons être transparents, parce que les démonstrations des éditeurs montrent rarement cette partie. Un modèle multimodal impressionnant sur dix exemples choisis peut se comporter très différemment sur dix mille documents réels.
Le premier point de fragilité, c’est la fiabilité sur les détails précis. Un modèle peut lire correctement l’essentiel d’une facture et pourtant confondre un 3 et un 8, ou ignorer une ligne dans un tableau dense. Pour une facture à enjeu faible, c’est tolérable avec une vérification par échantillonnage. Pour un montant qui déclenche un paiement ou un document à valeur légale, c’est un risque qu’il faut traiter explicitement, par exemple avec des contrôles de cohérence (le total correspond-il à la somme des lignes ?) et une validation humaine au-delà d’un certain seuil.
Le deuxième point, c’est la qualité des données d’entrée. Une photo prise de travers, un scan en basse résolution, un enregistrement avec du bruit de fond ou plusieurs personnes qui parlent en même temps : tout cela dégrade nettement les résultats. Les modèles sont plus tolérants que les anciens outils, mais ils ne font pas de miracle. Une partie du travail d’un projet réussi consiste à améliorer la capture en amont, par exemple avec des consignes simples aux équipes de terrain.
Le troisième point, ce sont les hallucinations visuelles et audio. Un modèle peut décrire avec aplomb un élément qui n’est pas dans l’image, ou “compléter” une phrase inaudible avec quelque chose de plausible mais faux. C’est le même phénomène que pour le texte, mais plus difficile à repérer, parce qu’on fait spontanément confiance à une description qui semble précise.
La vidéo longue reste enfin le terrain le plus immature. Analyser quelques secondes ou résumer une présentation filmée fonctionne plutôt bien. Suivre fidèlement une heure d’enregistrement de surveillance ou détecter un événement rare dans de longues séquences reste coûteux, lent et inégal. Si quelqu’un vous promet le contraire, demandez une démonstration sur vos propres données.
Coûts, confidentialité et dépendances : les angles morts
Au-delà de la qualité technique, trois sujets reviennent systématiquement dans nos échanges avec les décideurs, et ils sont souvent sous-estimés au démarrage.
Le coût d’abord. Traiter des images, du son ou de la vidéo consomme sensiblement plus de ressources que du texte seul, et la facture peut grimper vite quand le volume augmente. Un prototype qui coûte quelques euros sur cent documents peut devenir un poste de dépense significatif sur cent mille. Chiffrer le coût par document traité, dès la phase de test, évite les mauvaises surprises 🤑.
La confidentialité ensuite, avec un enjeu encore plus sensible qu’avec le texte. Une photo de chantier peut montrer des visages, une plaque d’immatriculation ou des informations clients. Un enregistrement d’appel contient des données personnelles et parfois des informations sensibles. Avant d’envoyer ces contenus vers un service tiers, il faut vérifier les conditions de traitement, l’hébergement des données et la base légale, notamment au regard du RGPD. Des enregistrements de personnes exigent par ailleurs, dans la plupart des cas, une information claire des personnes concernées.
La dépendance à un fournisseur enfin. Les modèles évoluent très vite : une mise à jour peut modifier subtilement les résultats, un modèle peut être retiré ou remplacé, les tarifs peuvent changer. Pour un usage critique, nous recommandons de concevoir l’intégration de façon à pouvoir changer de modèle sans tout réécrire, et de garder un jeu de documents de référence pour mesurer l’impact de chaque changement.
Notre méthode pour démarrer sans se brûler
Chez Agilap, nous considérons que le bon point de départ n’est pas la technologie, mais un cas d’usage précis avec un volume suffisant et un enjeu d’erreur maîtrisé. Nous suivons généralement la même démarche, que nous avons éprouvée sur plusieurs projets.
D’abord, constituer un jeu de test réaliste : cinquante à cent documents, photos ou enregistrements réels, y compris les plus difficiles, avec le résultat attendu pour chacun. C’est la seule façon de savoir ce que le modèle fait vraiment sur vos données, et pas sur celles de la démonstration. Ensuite, mesurer le taux d’erreur, et surtout le type d’erreurs : une erreur sur un champ secondaire n’a pas le même poids qu’une erreur sur un montant.
Ensuite, démarrer en mode “l’outil propose, l’humain valide”. Les gains de temps sont déjà réels, parce que relire est bien plus rapide que saisir, et vous collectez des données sur la fiabilité réelle. C’est seulement quand les chiffres sont stables sur plusieurs semaines qu’on peut alléger la validation sur les cas les plus simples, en gardant un contrôle renforcé pour les cas à fort enjeu.
Enfin, prévoir dès le départ la traçabilité : conserver le document d’origine, la réponse du modèle et la version corrigée par l’humain. Cela permet de comprendre les erreurs, d’améliorer le dispositif et de répondre en cas de litige. C’est un réflexe de bonne pratique qui ne coûte presque rien au démarrage et qui devient très précieux ensuite 💪.
Conclusion
Les modèles multimodaux ouvrent un vrai champ d’usages : des données jusque-là inexploitables deviennent lisibles, classables et résumables, et les premiers gains sont déjà accessibles pour une PME, notamment sur les documents hétérogènes, les comptes rendus oraux et le support client. Mais l’écart entre une démonstration et un système fiable en production reste réel, surtout sur la précision des détails, la qualité des données d’entrée, le coût à grande échelle et la vidéo longue.
Bref, la bonne solution est celle qui répond à votre contexte : un cas d’usage bien choisi, testé sur vos propres données, avec un humain dans la boucle au début. Si vous vous demandez quels contenus de votre entreprise pourraient être exploités par ces outils, et à quel niveau de fiabilité vous pouvez raisonnablement vous attendre, n’hésitez pas à nous contacter pour en discuter.
Bons projets et à bientôt, l’équipe d’Agilap 🌈